|
| 区域试验分析模型 |
| Test Model |
| 区域试验包括品种-年份-试验点 |
| Treat Model |
| 区域试验包括处理品种-处理-年份-试验点 |
| |
| |
| 原始数据格式 |
原始数据格式如同Sample文件夹中的CotTest.txt(适用于Test model)和CotTreat.txt(适用于Treat model)所示。CotTest.txt中前四列为固定不变的格式,分别是品种,年份,地点和区组, CotTreat.txt中 前五列为固定不变的格式,分别是品种数目,年份数目,试验点数目,处理数目,和环境内的区组数目。每列最小的数都是1, 相应最大值分别表示试验中的不同品种,年份,试点,处理数,和相同环境下的区组数。各列应按数值从小至大顺序依次排列。缺失数据用点号表示(".")。 |
| |
| |
| |
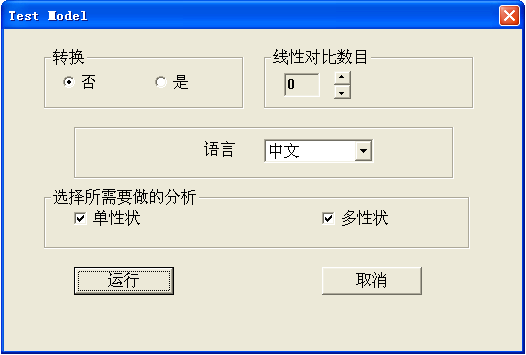
| 区域试验分析方法中的Test Model和Treat model具有相同的系数设置框,它将在您选定一个 试验分析方法模型后自动弹出。 |
|
| 1.转换 |
| 是否园艺将原始数据数据转换成对照品种的百分数。 |
| 2.线性对比数目 |
| 线性对比统计检验的数目可以是1至9。 |
| 3.语言 |
| 分析结果输出文件所使用的语言,可以选用中文或者英文。 |
| 4.单性状检验 |
| 选择这个选项,程序将分别估计每个性状随机效应方差和品种效应,结果将自动保存为filename.var。 |
| 5.多性状检验 |
| 选择这个选项,程序将估计多个性状加权均值随机效应方差和品种效应。结果将自动保存为filename.cov。 |
| 6.运行 |
| 运行已经设定系数的方法和模型。 |
| 7.取消 |
| 退出。 |
| |
| |
| 区域试验分析模型中的另两个模型 |
| TestR Model |
| 区域试验的随机效应分析 |
| TreatR Model |
| 包含处理的区域试验的随机效应分析 |
| |
| |
| 原始数据格式 |
原始数据格式如同Sample文件夹中的CotTest.txt(适用于TestR model)和CotTreat.txt(适用于TreatR model)所示。CotTest.txt中前四列为固定不变的格式,分别是品种,年份,地点和区组, CotTreat.txt中 前五列为固定不变的格式,分别是品种数目,年份数目,试验点数目,处理数目,和环境内的区组数目。每列最小的数都是1, 相应最大值分别表示试验中的不同品种,年份,试点,处理数,和相同环境下的区组数。各列应按数值从小至大顺序依次排列。缺失数据用点号表示(".")。 |
| |
| |
| |
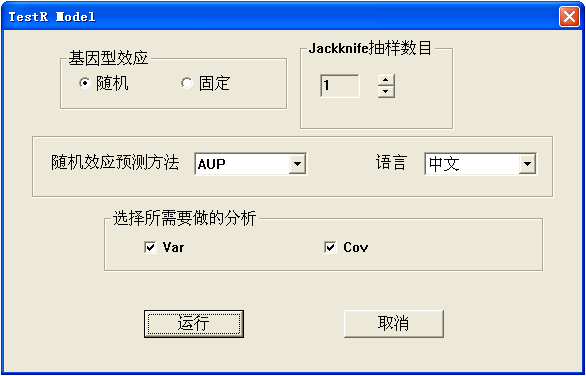
| 区域试验分析方法中的TestR Model和TreatR model具有相同的系数设置框,它将在您选定一个 试验分析方法模型后自动弹出。 |
|
| 1.基因型效应 |
| 选择基因型(品种/处理效应)作为随机或者固定效应。 |
| 2.Jackknife抽样数目 |
| Jackknife抽样数据可以是1至9. |
| 3.随机效应预测方法 |
| AUP (adujusted unbiased prediction) 或者 LUP (linear unbiased prediction) 都可以预测随机效应值。 |
| 4.语言 |
| 分析结果输出文件所使用的语言,可以选用中文或者英文。 |
| 5.Var |
| 当选择此选项,程序将估计方差分量并且预测随机效应。结果将自动保存为filename.vgr。 |
| 6.Cov |
如果选择这个选项,程序将估计协方差分量和相关系数,但是此选首先选择Var。如果基因效应是随机的,那么结果将保存为filename.crr;如果基因效应是固定的,结果将自动保存为filename.cfr。 |
| 7.运行 |
| 运行已经设定系数的方法和模型。 |
| 8.取消 |
| 推出。 |
|