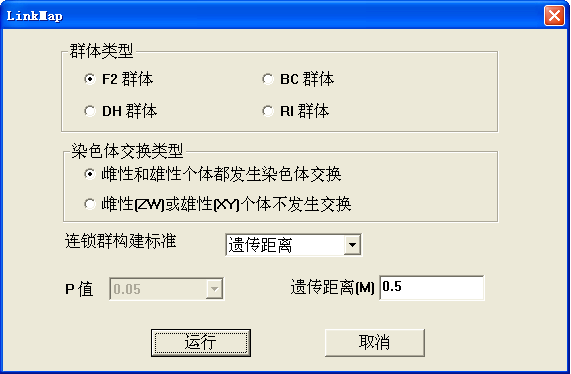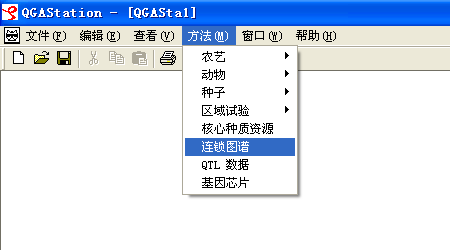
原始数据格式如同Sample文件夹中的Linkage.txt, BCMark1.txt, DHMark1.txt, DHMark2.txt, F2Mark.txt, LinkageZW.txt和MarkDH.txt所示。第一列与第二列分别表示个体 或样本编号和性别代号。性别代号的定义: 0表示无性别;1 是ZW雌性或XY雄性; 2是 ZZ雄性或XX雌性。对于第一列,最大的数据就等于所具有的个体数目。 从第三列开始,每列都标示了一个分子标记,其值由分子标记类型和配偶类型决定:1表示P1; 2表示P2; 3表示F1; 4表示F1或者P1(M_) ; 5表示F1或者P2(m_); 缺失分子标记信息用西文字符”.”表示。这些数据要依次顺序排列。缺失数据用点号表示(".")或者1~5以 的正整数表示。 文件中的第一个观察值的个体编号最好为1,否则可能发生数据漏读。当已知某几个分子标记是位于同一条染色体上,但是结果却可能因为较苛刻的连锁群构建标准而处于不同的连锁群中,那么需要按照以下步骤调整:(1)处于不同连锁群的标记保存在不同文件,(2)选择较大的遗传距离。然后在运行程序。