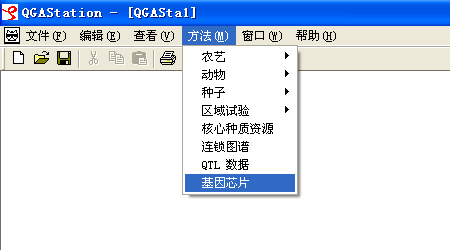
数据格式如同Sample文件夹中ChipLog1.txt,Example05.txt所示。
第一列是基因编号,
第二列是芯片编号,
第三,第四列是试验因素,如果只有一个试验因素,那么请将试验因素放置在第三列,第四列全部置为1。
第五列是染色效应(1表示cy3染料,2表示cy5染料),如果不是一个正反染色的试验,那么此列全部标记为1。
第六列是芯片的表达数据,缺失数据用99999.000表示。
此模块由陆燕开发。

|
| 原始数据格式 |
数据格式如同Sample文件夹中ChipLog1.txt,Example05.txt所示。
第一列是基因编号,
第二列是芯片编号,
第三,第四列是试验因素,如果只有一个试验因素,那么请将试验因素放置在第三列,第四列全部置为1。
第五列是染色效应(1表示cy3染料,2表示cy5染料),如果不是一个正反染色的试验,那么此列全部标记为1。
第六列是芯片的表达数据,缺失数据用99999.000表示。 此模块由陆燕开发。 |
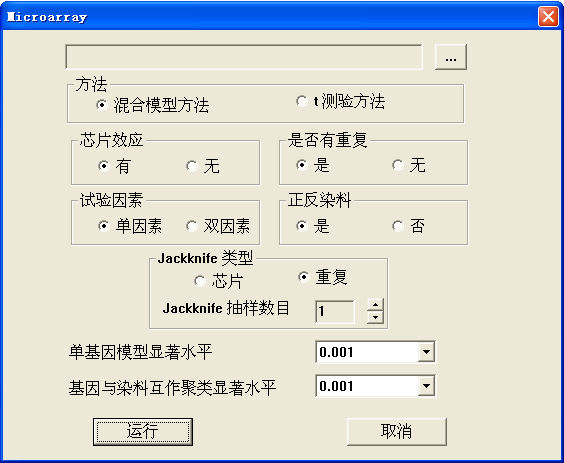
| 基因芯片分析方法中的所有模型具有相同的系数设置框。 |
|
| 1. |
| 打开文件,选择数据所在位置。 |
| 2.芯片效应 |
| 如果有芯片效应,就选择有;反之,选无。 |
| 3.重复 |
| 如果有重复,就选择有;反之,选无。 |
| 4.试验因素 |
| 如果是双因素试验设计,选择2,如果是单因素试验设计,选择1。 |
| 5.正反染色 |
| 如果是正反染色,选择是,否则,选择否。 |
| 6.单基因模型显著水平 |
| 单基因模型有六个水平可供选择: 0.01, 0.005, 0.001, 0.0005, 0.0001 和 0.00005. 对于固定模型,默认值 0.001。 |
| 7.基因与处理互作效应聚类的显著水平 |
| 有四个水平可供选择: 0.05, 0.01, 0.005 and 0.001. 对于固定模型,默认值0.001。 |
| 8.运行 |
| 运行. 结果文件将自动保存为 filename.out, filename.eft, tprob.txt 记录了单基因模型所筛选的基因的显著水平。一般而言, <0.001显著水平比较适合cDNA 芯片数据的分析. name.txt 记录了基因编号,芯片编号和试验因素编号,是对原始数据的扫描. 用户可以对照这个文件,检查程序的数据读取是否正确。 |
| 9.取消 |
| 退出,放弃程序运行。 |