|
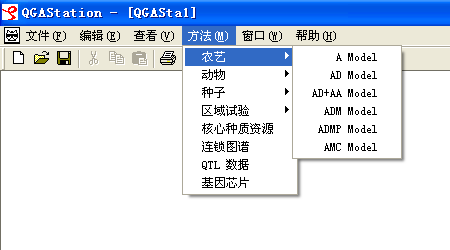
| 农艺性状分析模型 |
| A Model |
| 加性遗传模型(G, GE) |
| AD Model |
| 加性-显性遗传模型(A, D, AE, DE) |
| AD+AA Model |
| 加性-显性-上位性遗传模型(A, D, AA, AE, DE, AAE) |
| ADM Model |
| 加性-显性-母体效应遗传模型(A, D, M, AE, DE, ME) |
| ADMP Model |
| 加性-显性-母体效应-父体效应遗传模型(A, D, M, P, AE, DE, ME, PE) |
| AMC Model |
| 花药加性-母体效应-细胞质效应遗传模型(A, M, C) |
| |
| |
| 原始数据格式 |
| 原始数据格式如同Sample文件夹中的CotData.txt 和CotF1F2.txt所示, CotBoll.txt是一个表型发育的样本数据,记录了不同时期的表型。 前五列是固定不变的格式,依次是:环境(例如 年份或者地点),母本,父本,世代,和区组。世代代码编号,0表示双亲,1表示F1,2表示F2,3表示F1×Pi,4表示F1×Pj,5表示Pi×F1,6表示Pj×F1。固定列的其他各列的最小值都是1, 相应最大值分别表示环境的数目,在第二列与第三列表示亲本数目,在第五列表示相同环境下的区组数目。各列应按数值从小至大顺序依次排列。缺失数据用点号表示(".")。 |
| |
| |
|
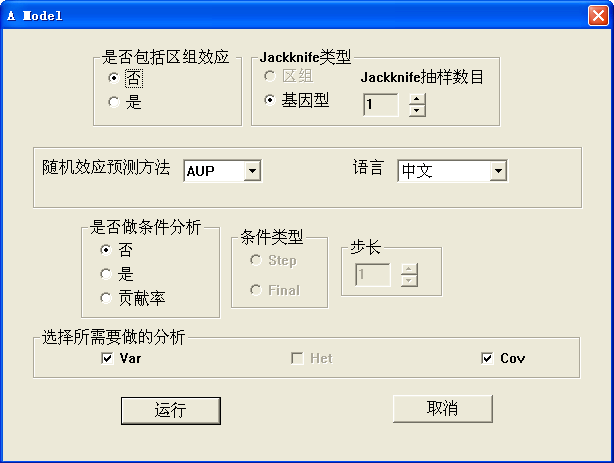
| 农艺性状分析方法中的所有模型具有相同的系数设置框,它将在您选定一个农艺方法模型后自动弹出。 |
|
| |
| 1.是否包括区组效应 |
| 选择“否”表示原始数据不包括区组 效应(这个时候,原始数据区组所在列编号都是1);或者在区组存在的情况下忽略区组效应,而将区组当试验的重复看待。选择“是”表示包括区组效应 ,而且试验数据中的确有区组存在(这个时候,原始数据区组所在列编号应该是1,2,3……)。 |
| 2.Jackknife 类型 |
| 当区组效应选项为否,基因型将是默认的Jackknife类型选项。当区组效应选项为是,基因型与区组都是可选的。 如果Jackknife类型选项为区组,则Jackknife抽样数目将默认为1。 |
| 3.Jackknife 抽样数目 |
| Jackknife 重复抽样单位数目可以是1 至 9。 如果试验存在重复,那么Jackknife的抽样数目建议是重复数的整数倍。 |
| 4.语言 |
| 分析结果输出文件所使用的语言,可以选用中文或者英文。 |
| 5.随机效应预测方法 |
| AUP (adujusted unbiased prediction) 或者 LUP (linear unbiased prediction) 都可以预测随机效应值。 |
| 6.是否做条件分析 |
| 如果不作条件分析,选择“否”,此时,条件类型与步长将不可选择,并且无效;如果作条件分析,可选择“是”,并可进一步选择条件类型及步长。当选择贡献率时,条件类型自动为Final型,步长为1,而且只有var可以进行运算。 |
| 7.条件类型 |
| 对性状观测值做后项(第t项)对前项(第t-n项)的顺序条件分析(t|t-n),可选择“Step”类型 ;如果想分析最终性状与此前任一时刻的条件分析(f|t),可选择“Final”类型。当条件类型为Final时,步长值将为默认值。条件类型为Step时,步长值可以 根据数据调整。 |
| 8.步长 |
| 步长值可以从1至9,应该根据原始数据的情况以及所关心的分析对象选择适当的值 ,但是步长值不可大于等于总性状数。当条件类型为Final时,步长为默认值,不需要设定,将依次对性状最后时期在给定前面任一时期的条件分析。 |
| 9.Var |
| 当选择这个选项,程序将根据选择的模型估计性状方差分量并且预测随机效应。结果将自动保存为filename.var。 |
| 10.Het |
| 如果选择这个选项,程序将预测杂种优势。结果将自动保存为filename.pre对于A, ADM, ADMP, 和 ADGE模型,这个选项不可选。 |
| 11.Cov |
| 如果选择这个选项,程序将估计协方差分量和相关系数,但是此选项需要首先选择Var和/或Het选项。结果将自动保存为filename.cov。 |
| 12.运行 |
| 运行已经设定系数的方法和模型。 |
| 13.取消 |
| 退出。 |
|